模型已可用 边缘正当时
导语
上一篇内容,我们围绕"模型侧"进行了介绍:可用模型正批量出现,竞争焦点从参数量转向长任务完成度,而端侧部署也已经从"能不能装下"变成了"如何发挥好"——装得下只是入场券,真正决定体验的,是承载模型的芯片。
本篇及下篇内容,将围绕适配可用模型的边缘侧 AI 芯片选型要素进行拆解,助你的选型抉择更加精准高效。
支持的模型类型要多
——LLM、扩散模型等都得跑
边缘场景从来不是单一模型的舞台。一台边缘设备要承载的真实负载,往往同时包含多种模型:
LLM、VLM 类:对话、问答、代码补全、Agent 编排——推理分 prefill 与 decode 两阶段,重带宽;
扩散类(生成):文生图、图像编辑、视频生成、语音合成——需要多步迭代,重算力;
多模态与专用小模型:视觉理解、ASR / TTS、Embedding、小目标检测——结构五花八门。
为什么把这一点放在最前面?因为模型的演进速度远快于硬件。一颗芯片的生命周期通常 3-5 年,而主流模型架构两三年就会换代一次。只为一类模型优化的芯片,在模型换代那天就会"过时";而"模型类型支持广"的芯片,才能跟上生态节奏,让用户的每一代模型都跑得动。
对芯片设计而言,这带来三条要求:
算力单元要通用:既擅长 LLM 的 GEMM / GEMV(decode 阶段的瘦长矩阵乘),也能覆盖扩散模型的卷积与 Attention 算子;
内存与带宽要能兼顾两类负载:LLM 重带宽(decode 快靠带宽)、扩散重算力(采样快靠算力),两者不能偏废;
软件栈要敏捷:新模型结构出现时,靠编译器与算子库快速适配,而不是回炉重造
这三条,爱芯元智一直以来都原生支持:算力单元从第一代产品起就同时覆盖 LLM 与 CNN 模型,内存与带宽的设计兼顾两类负载,软件栈则靠编译器与算子库让新模型结构快速适配——"模型类型支持广",从来不是口号,而是设计基线。
算力与内存带宽,decode 由带宽决定
选边缘 AI 芯片,很多人第一眼看 TOPS(算力)。但真正决定生成体验的,往往是另一个数字:内存带宽。
推理的两大要素:prefill 与 decode
prefill(处理你的提问):一次性并行计算整段输入,矩阵乘密集,是算力(compute)敏感的;
decode(逐字生成回答):自回归地一个 token 一个 token 往外吐,每一步都要把权重从内存里读一遍,是带宽(memory bandwidth)敏感的。
一道简单的算术题
decode 的理论上限:
每秒生成的 token 数 ≈ 内存带宽 ÷ 每 token 需读取的权重字节数
以 27B 模型为例(每 token 需读取的字节约等于模型权重体积):
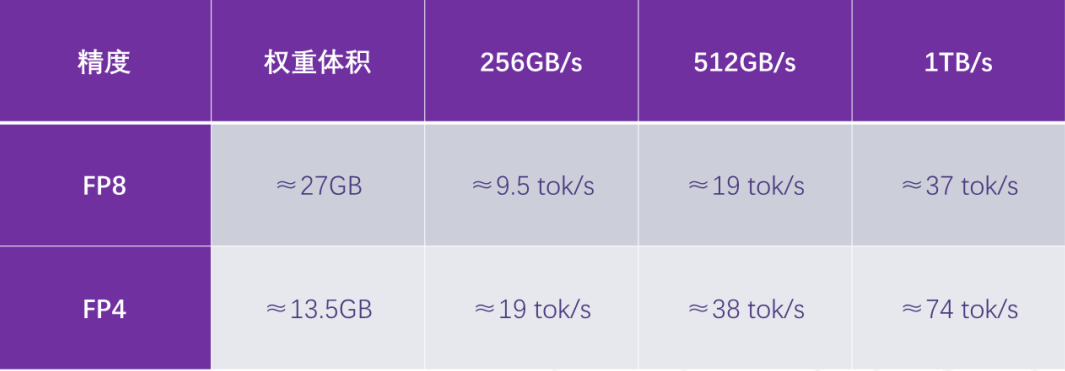
扣除 KV cache 与系统开销后,实际还要再打折扣。内存带宽直接决定用户感受到的"打字速度",带宽翻倍,生成速度就接近翻倍。
对芯片设计的启示
算力(TOPS)保证 prefill 速度和并发上限;
带宽保证 decode 的体验;
两者必须匹配,否则高 TOPS 在 decode 阶段就是"闲置资产"。边缘侧通常用 LPDDR / DDR 而非 HBM(成本与功耗约束),带宽更稀缺,因此"算力带宽配比"的设计功夫,恰恰是边缘 AI 芯片的差异化所在。爱芯元智把内存带宽作为与算力并列的一级指标设计,实现了业内领先的内存带宽。
内存容量,最容易被忽视的硬指标
选芯片看 TOPS,就像买车只看马力——马力再大,油箱太小照样跑不了长途。AI 芯片的"油箱",就是内存容量。
权重必须"住"在内存里
推理时,模型权重必须整体驻留内存才能参与计算。内存容量决定了:这颗芯片到底能装下多大的模型。这是芯片选型的"入场券"——TOPS 高而内存小,等于把跑车堵在车库里。
容量需求的三个组成部分
模型权重:27B FP4 ≈ 13.5GB,FP8 ≈ 27GB;
KV cache:与上下文长度成正比,长上下文是当前模型的标配能力,这部分会吃掉大量内存。
运行时与系统开销。
因此,"能装下 27B 模型"的真实门槛,往往不是 13.5GB,而是 16GB 甚至更高。把"这颗芯片能装下什么模型"列成一张表,比只报 TOPS 更能说明产品定位。例如:
14GB 内存 → 8B 模型 FP8 / 27B 模型 FP4;
32GB 内存 → 27B 模型 FP8 / 32B 模型 FP4 + 长上下文;
64GB+ 内存 → 更大模型与多路并发。
爱芯元智提供单芯片支持 128GB内存容量,面向 27B 及同级模型原生设计,让"可用模型完整装入边缘设备"成为默认能力,而不是勉强为之。
支持的模型类型要多(能不能跑得动多种模型)、算力与内存带宽要够(能不能跑到可用的生成速度)、内存容量要足(能不能装下权重与长上下文 KV cache),这三项是硬指标,也是选型的及格线——任何一项不达标,芯片直接出局。
对于模型侧芯片选型要素,本篇内容解决的是“能不能承接”的问题,下篇内容,将注重“能不能跑好”的权衡,敬请持续关注。
- 随机文章
- 热门文章
- 热评文章
- 激发假日经济活力为消费“添柴加火”
- 400套经适房被曝违规出租后,执法部门称“整改过”,中介称“照样租”
- 美参议院投票结束针对国土安全部长的弹劾审判
- EBC GROUP平台外汇行情播报|伊朗和委内瑞拉被点名 新制裁推升油价
- MH迈汇:OPEC+对抑制油价上涨至100美元至关重要
- 和谐共生|“为子孙后代留下可持续发展的‘绿色银行’”
- 受下游铁水产量回升带动 双焦氛围改善
- 【世界说】美媒:“中国产能过剩论”不攻自破 保护主义危及全球能源转型
- 走进上飞院,学习“大飞机精神”――上海人寿组织中高级管理人员及党员骨干赴中国商飞参观学习
- 中央气象台:西北地区有沙尘天气
- 半年补齐两位核心高管!富德产险成功扭亏,风险评级尚处C类
- 天齐锂业:境外少数股东收益暴增,SQM核心锂业务面临变动风险!
- 百亿私募最新持仓曝光!邓晓峰、冯柳动作频频,两大神秘私募清仓茅台?
- 1“赛事+”提升城市“流量” 陕西商洛拓经济发展新“赛道”
- 2“五一”临近 持基过节的投资者要注意这几点
- 3华发股份:成功入选“人民优选”品牌 五一黄金周热销30亿
- 4到2027年产业规模达到2000亿元 浙江发布历史经典产业高质量发展计划
- 5钟鼓楼老街区的古都新事
- 6IDC:24Q1全球PC出货量恢复增长 达到疫情前水平
- 7非常危险!女子摔成粉碎性骨折!又是因为洞洞鞋,夏天多人中招……
- 8金税四期试点上线,财税体制改革拉开帷幕!或有资金借道信创ETF基金(562030)逢跌进场布局
- 9初步数据:我国一季度经常账户顺差392亿美元
- 10“发现山西之美”TDC旅游发现者大会举办:共话文旅新生态 邀客体验新玩法
- 11国门“夫妻档” 国庆共坚守
- 12北交所一周审核动态:2家企业更新进展 胜业电气二轮问询回复中称家电头部客户对价格敏感度较低
- 13甘肃白银县域经济:从“一枝独秀”到“多点开花”
- 1大裁员下,特斯拉两名顶级高管离职
- 2奇瑞将与欧洲高端品牌签署技术平台授权协议
- 32024中国长三角青年企业家交流大会在杭州举办
- 4雷克萨斯GX中东版 全部在售 2023款 2022款 2020款 2019款 2018款成都远卓名车雷克萨斯GX中东版团购钜惠20万 欢迎上门试驾
- 5零跑C16将搭载中创新航磷酸铁锂电池
- 6Q1净利微增7%,宁德时代股东总数较2023年年末减少10728户
- 7哪吒,需要背水一战
- 8“新”中有“机”!创新服务承接新流量 撬动消费升级
- 9非创始版SU7何时交付 小米:工厂生产爬坡 全力提高产能
- 10央媒评卧铺挂帘:谁买的票谁做主
- 11江西南昌首部“多规合一”国土空间总体规划获批
- 12方程豹旗舰硬派越野!豹8正式亮相:仰望U8“青春版”登场
- 13583家族/造型霸气 方程豹豹8量产版发布